Lo que aprenderás: Cómo aplicar el stack de fiabilidad de proveedores, un modelo de atribución de fallos en tres capas, en tiempo real. Después de leer esto, podrás asignar cualquier fallo de pago a su capa correcta en minutos y tomar la acción de remediación adecuada antes de que se programe un post-mortem.
La tesis es directa: la mayoría de los equipos de pagos culpan al proveedor cuando el fallo estaba en su propia configuración de enrutamiento, y culpan a su configuración cuando el fallo estaba en el rail. La razón no es descuido. Es la ausencia de un modelo para distinguirlos bajo presión. Este artículo te da ese modelo.
Conclusiones clave
- Tres capas distintas producen tres firmas de fallo distintas. Tratarlas como una sola retrasa la recuperación y desvía el esfuerzo de ingeniería.
- Los fallos de rail son visibles en todos los proveedores de forma simultánea. Una degradación de un solo proveedor es siempre un evento de Capa 2, no un evento de rail.
- Los fallos de configuración son los más comunes y los más corregibles. También son los más propensos a diagnosticarse erróneamente como problemas del proveedor.
- El enrutamiento automático de respaldo limita el radio de impacto de la Capa 2, pero solo si la cadena de respaldo está configurada y activa antes del incidente.
- El modelo funciona en minutos. No necesitas un post-mortem para asignar una capa. Necesitas tres preguntas de triage.
Por qué la atribución incorrecta es el verdadero modo de fallo
Cuando la tasa de aprobación cae, el primer instinto es llamar al proveedor. Ese instinto es incorrecto con suficiente frecuencia como para costar ingresos reales.
Considera lo que ocurre durante un incidente en producción. La alerta de monitoreo se dispara. Alguien abre un ticket con el proveedor. El equipo de soporte del proveedor pide los IDs de transacción. Pasan veinte minutos. Mientras tanto, el volumen se drena.
Si la causa raíz era una cadena de respaldo mal configurada, el ticket al proveedor no sirve de nada. La solución siempre estuvo a un cambio de reglas de enrutamiento de distancia. Según la Documentación de Yuno Monitors, al detectar tasas de aprobación bajas, el sistema redirige automáticamente los pagos a proveedores de respaldo, manteniendo una pequeña porción en el proveedor original para vigilar la recuperación. Esa automatización solo funciona si la cadena de respaldo estaba correctamente configurada desde el principio. Cuando no lo estaba, la alerta se dispara y nada captura el volumen.
El error inverso es igual de dañino. Un equipo reescribe su configuración de enrutamiento durante una interrupción a nivel de esquema. La interrupción termina. La configuración reescrita introduce un nuevo bug. Ahora el equipo tiene dos problemas donde antes tenía uno.
El modelo de tres capas definido
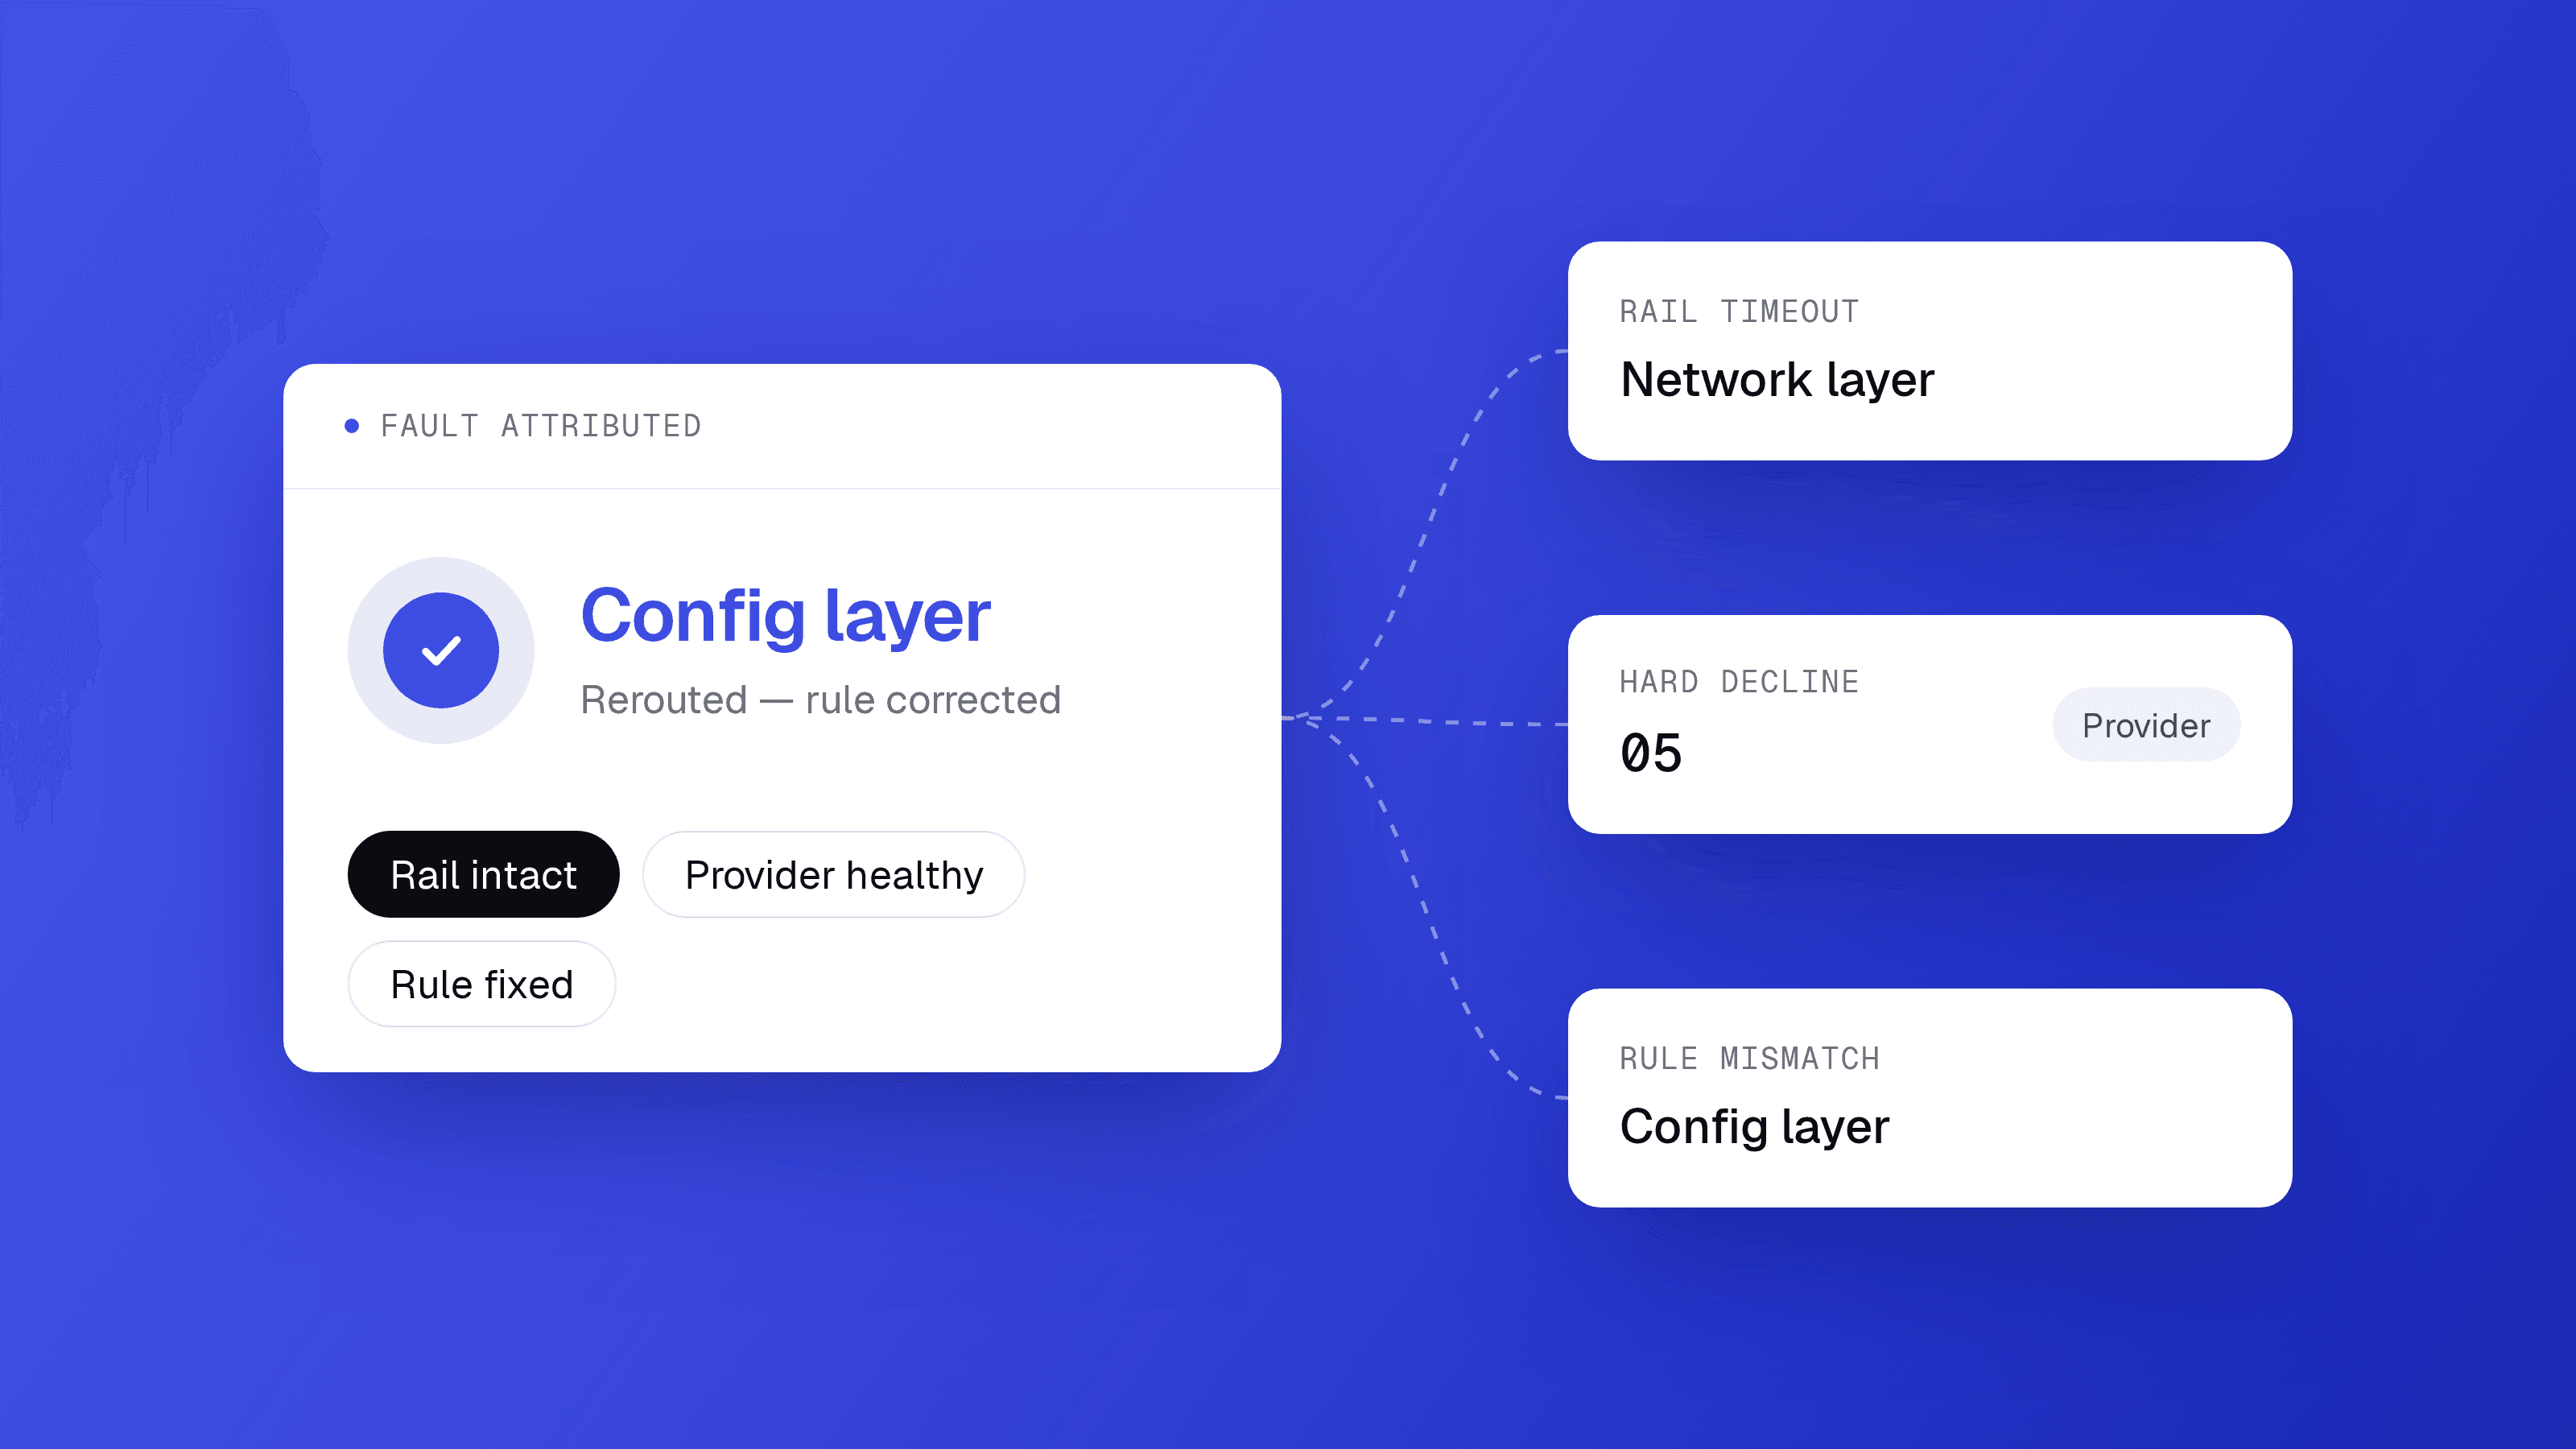
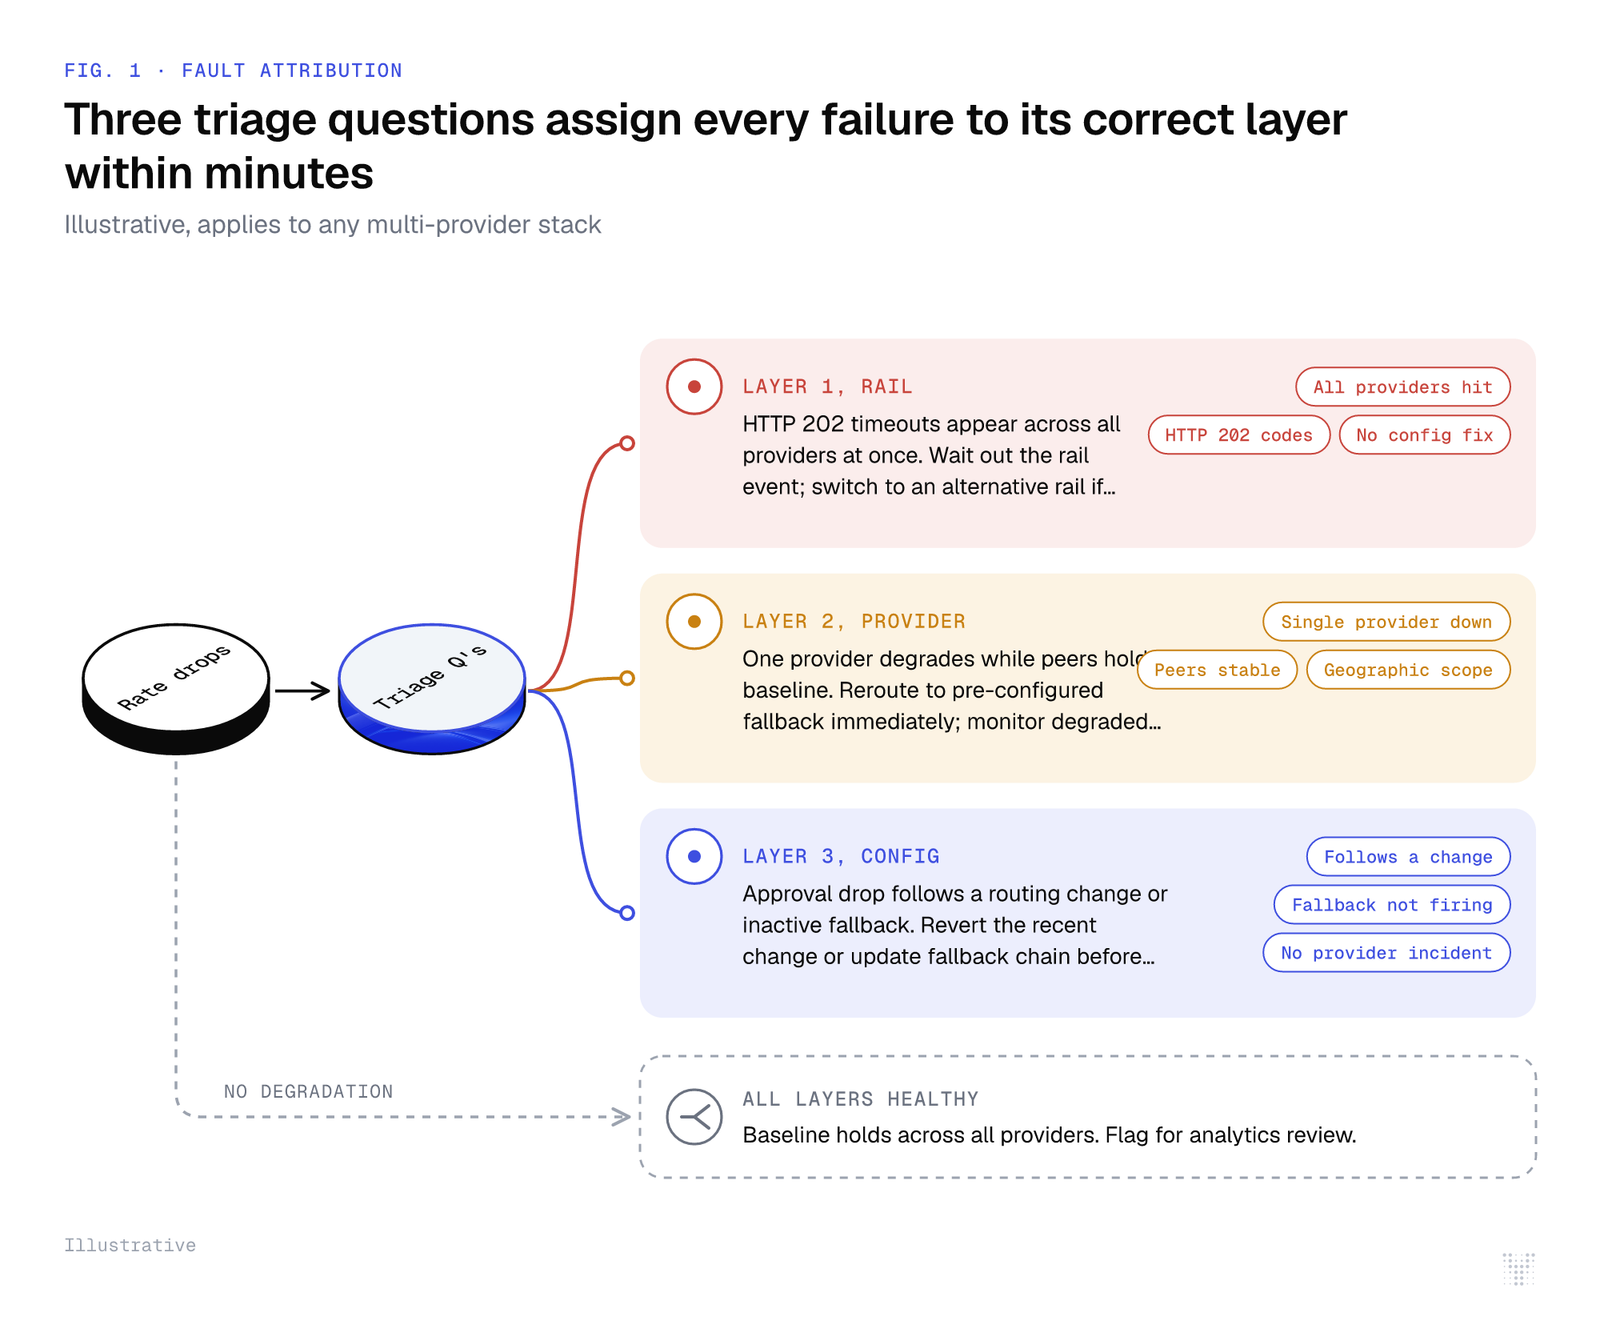
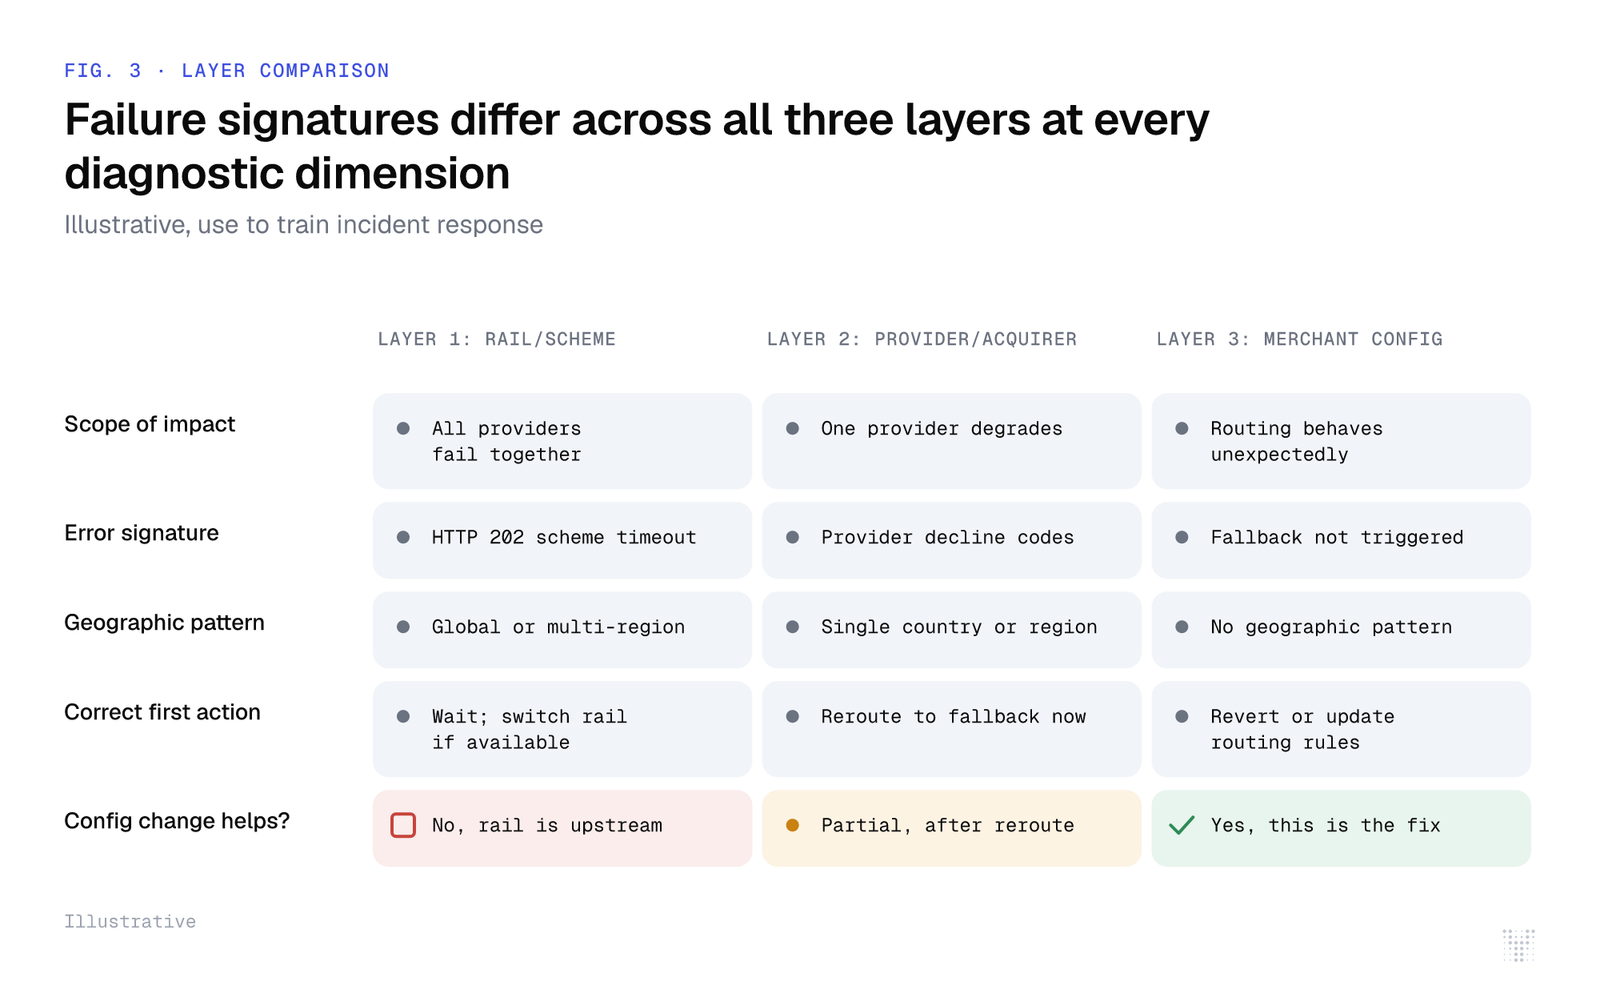
El stack de fiabilidad de proveedores tiene tres capas, cada una con un propietario diferente, una firma de fallo diferente y una respuesta correcta diferente. El modelo en una frase: cuando la aprobación cae, determina si el alcance del fallo es universal, específico de un proveedor, o correlacionado con un cambio de comportamiento, y actúa sobre la capa que corresponde.
Capa 1: El rail o esquema de tarjeta
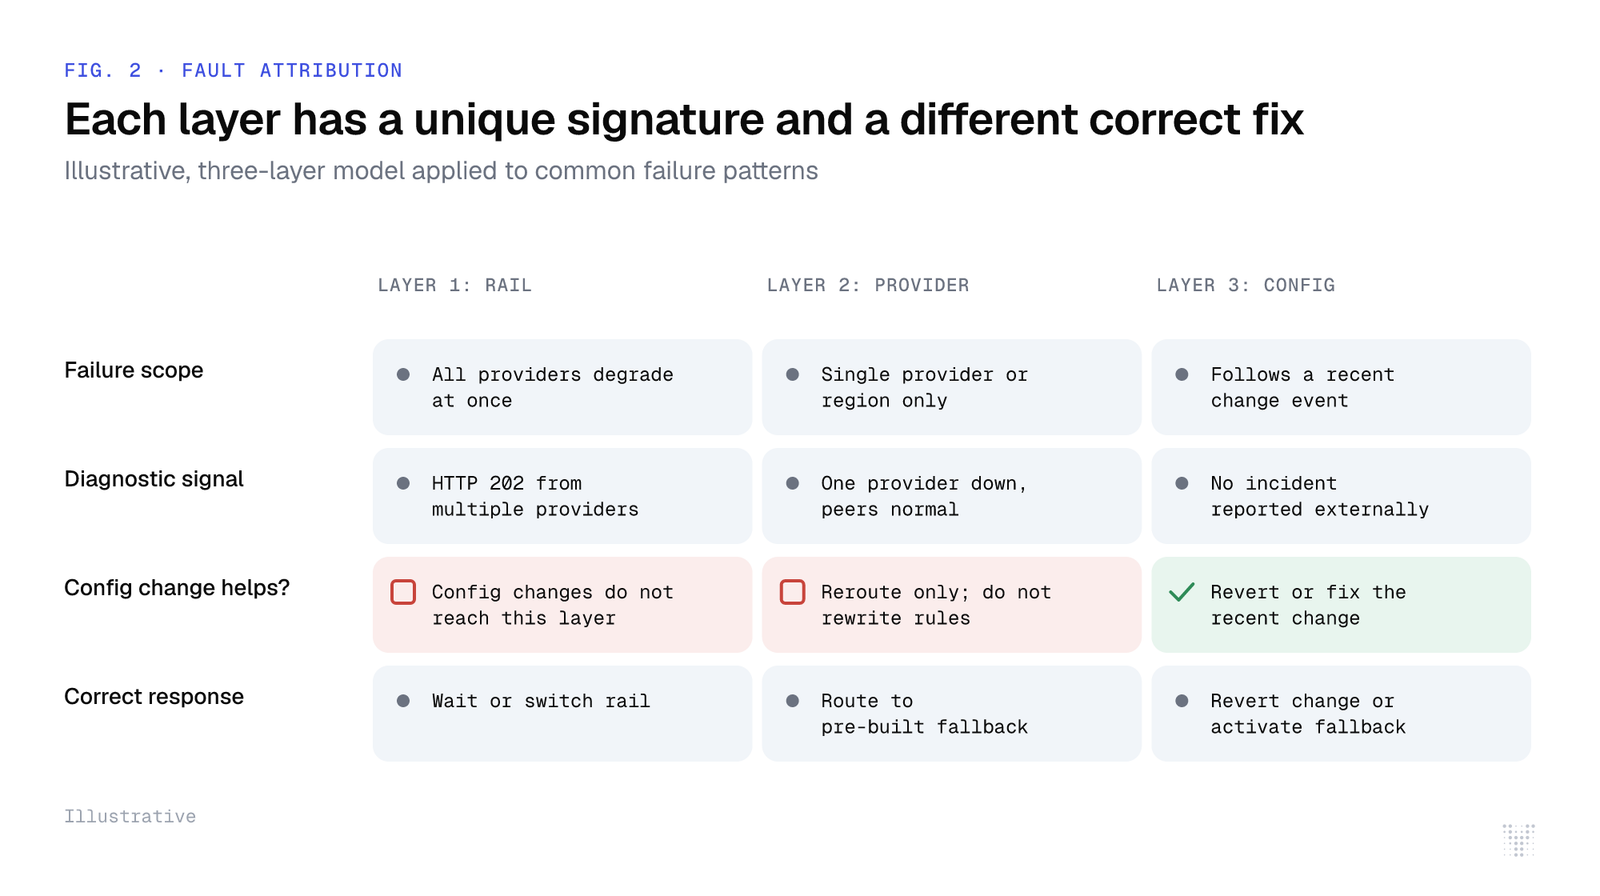
Esta capa está por encima de todos los proveedores. Ningún cambio de configuración a nivel de comercio la alcanza. Cuando falla, todos los proveedores fallan juntos.
La firma de diagnóstico es específica. Según los Visa Direct Error Codes, un timeout de esquema devuelve un código de estado HTTP 202 cuando la red no puede completar una transacción en 30 segundos. Si ves respuestas HTTP 202 llegando de múltiples proveedores independientes al mismo tiempo, estás ante un evento de Capa 1. La respuesta correcta es esperar, cambiar a un rail alternativo si hay uno disponible, y no realizar ningún cambio en la configuración de enrutamiento.
La palabra clave es simultáneamente. Si un proveedor devuelve HTTP 202 y otro procesa con normalidad, el fallo no está en el rail.
Capa 2: El proveedor o adquirente
Los fallos en la capa de proveedor tienen un alcance geográfico e institucional. Afectan a un procesador, un banco o una región. Según la documentación Smarter STIP de Visa, un gran procesador canadiense experimentó una interrupción de STIP de ocho horas en febrero de 2019, con 600,000 transacciones declinadas a una tasa de aprobación del 0%. Un importante banco latinoamericano experimentó una interrupción de tres horas el mes anterior. Esos son eventos de Capa 2: contenidos en un proveedor, con un patrón geográfico claro.
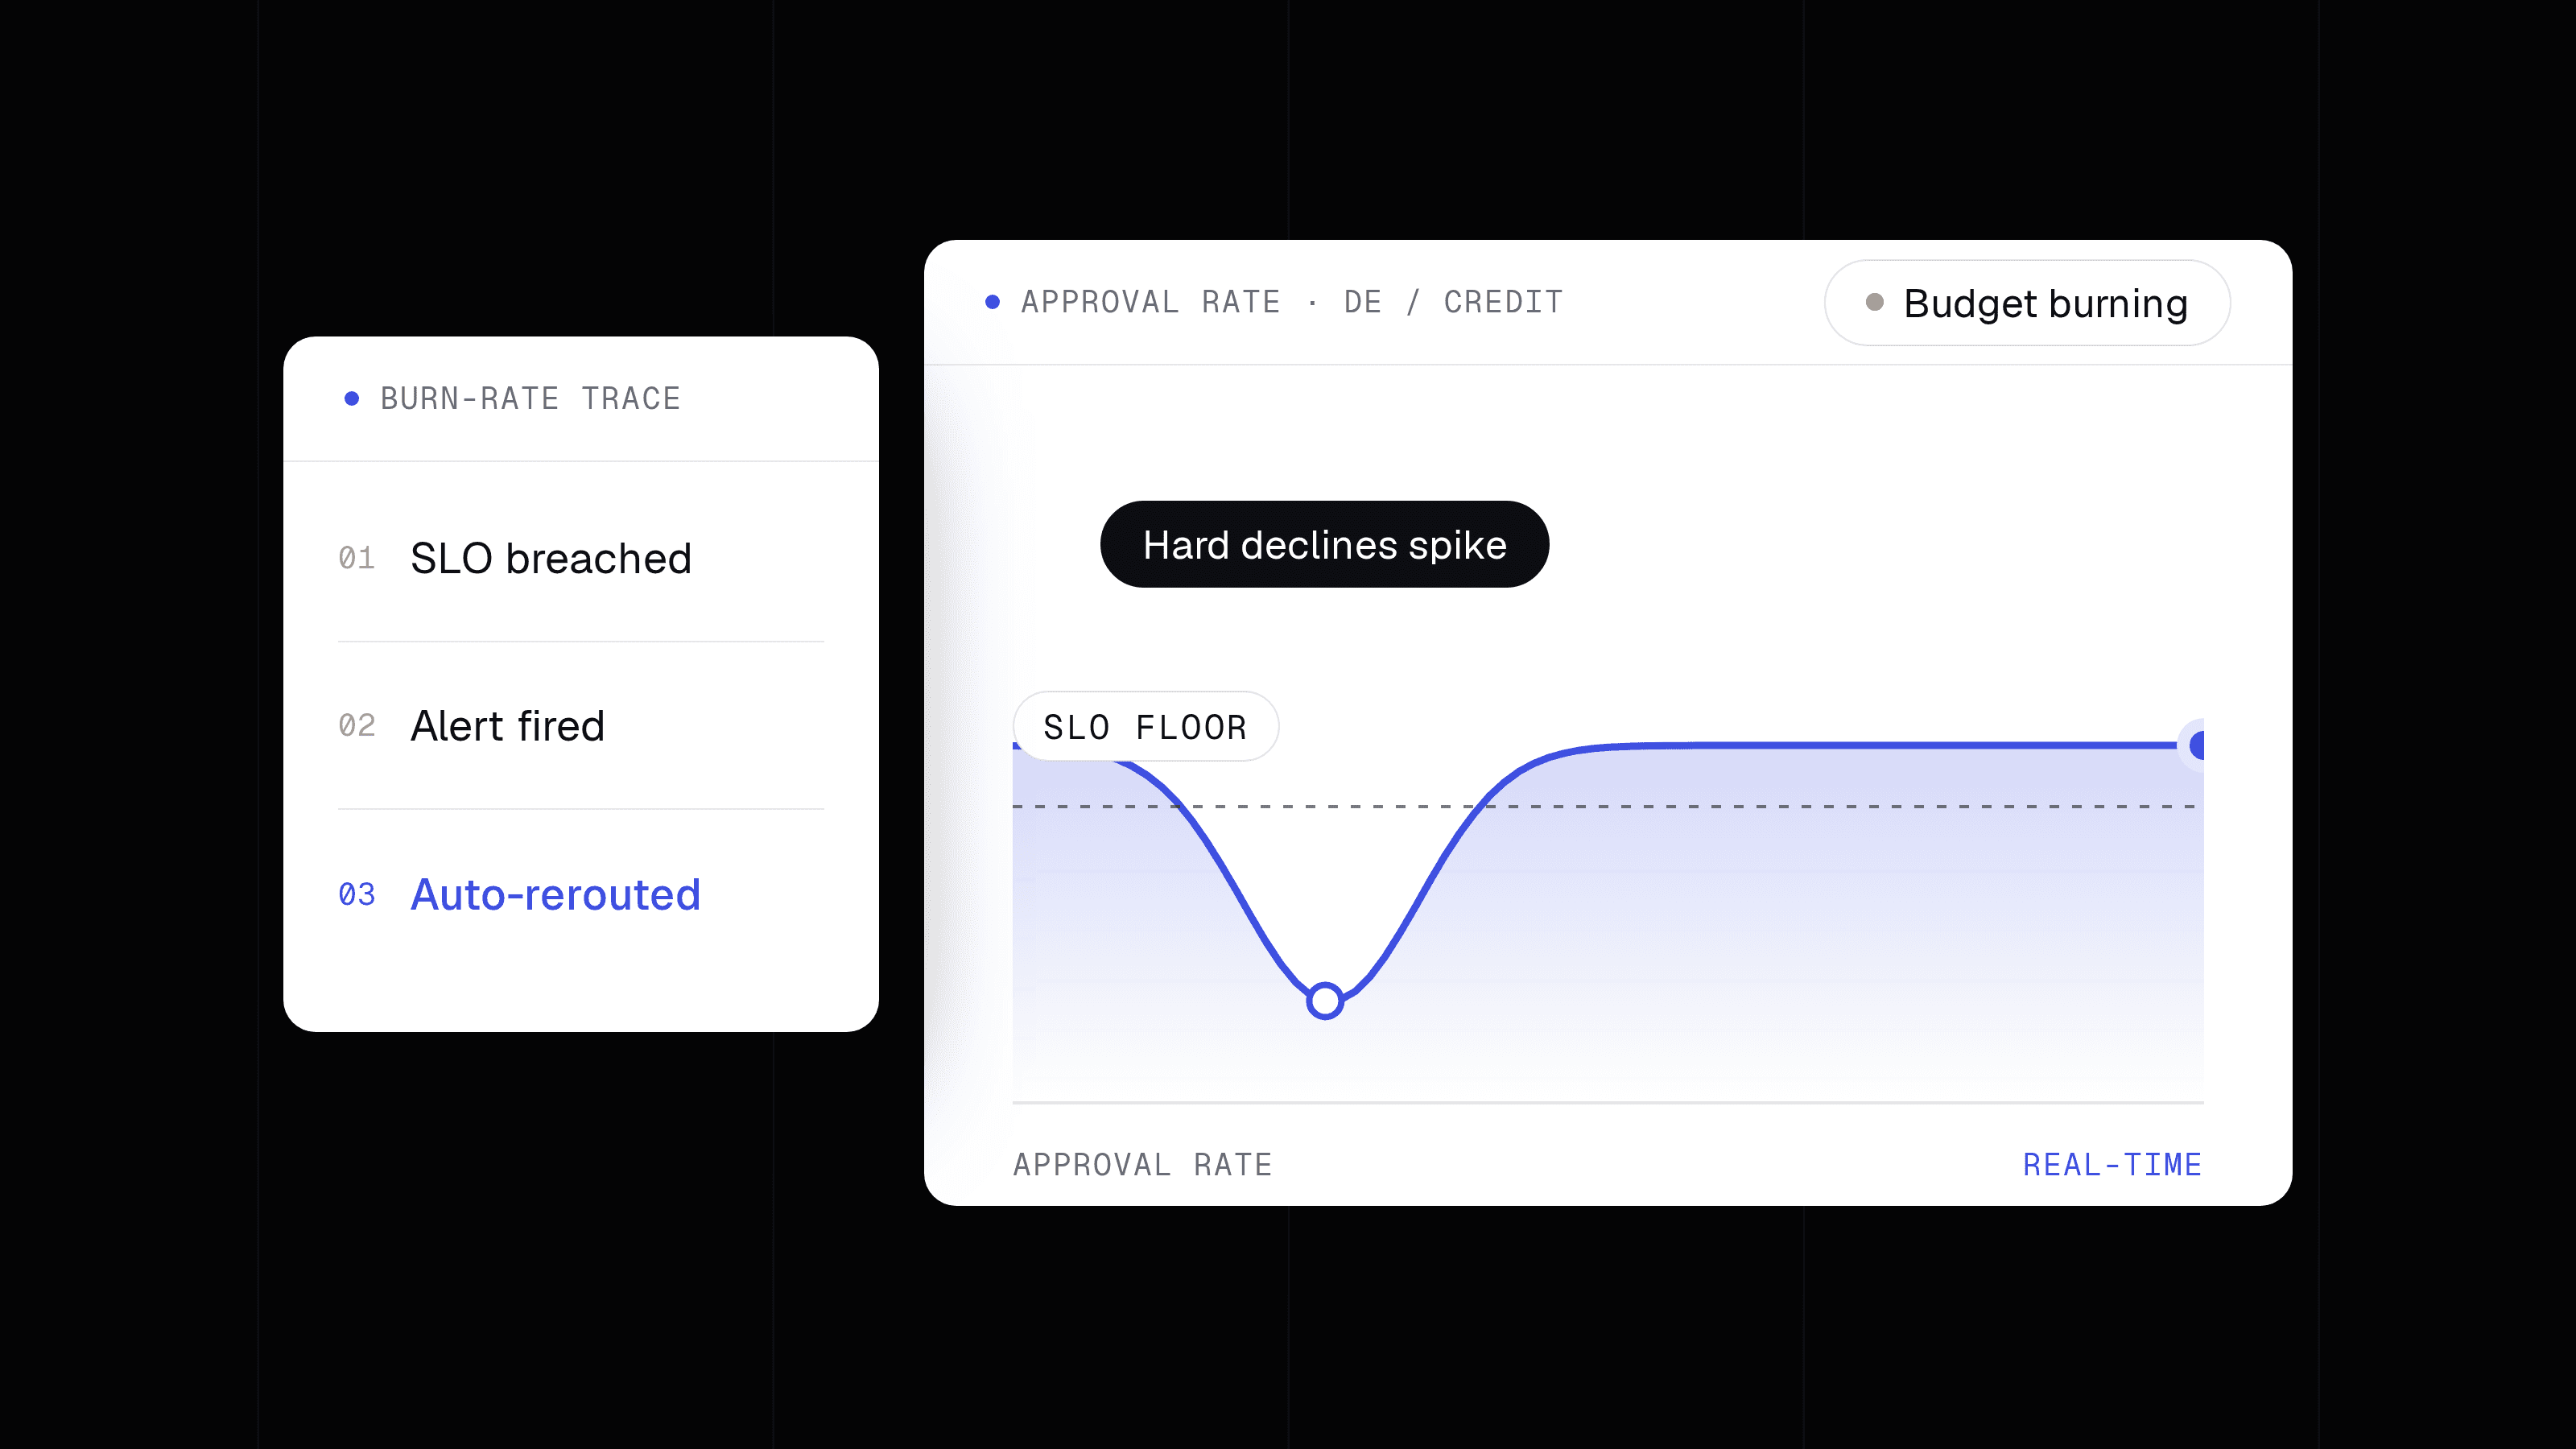
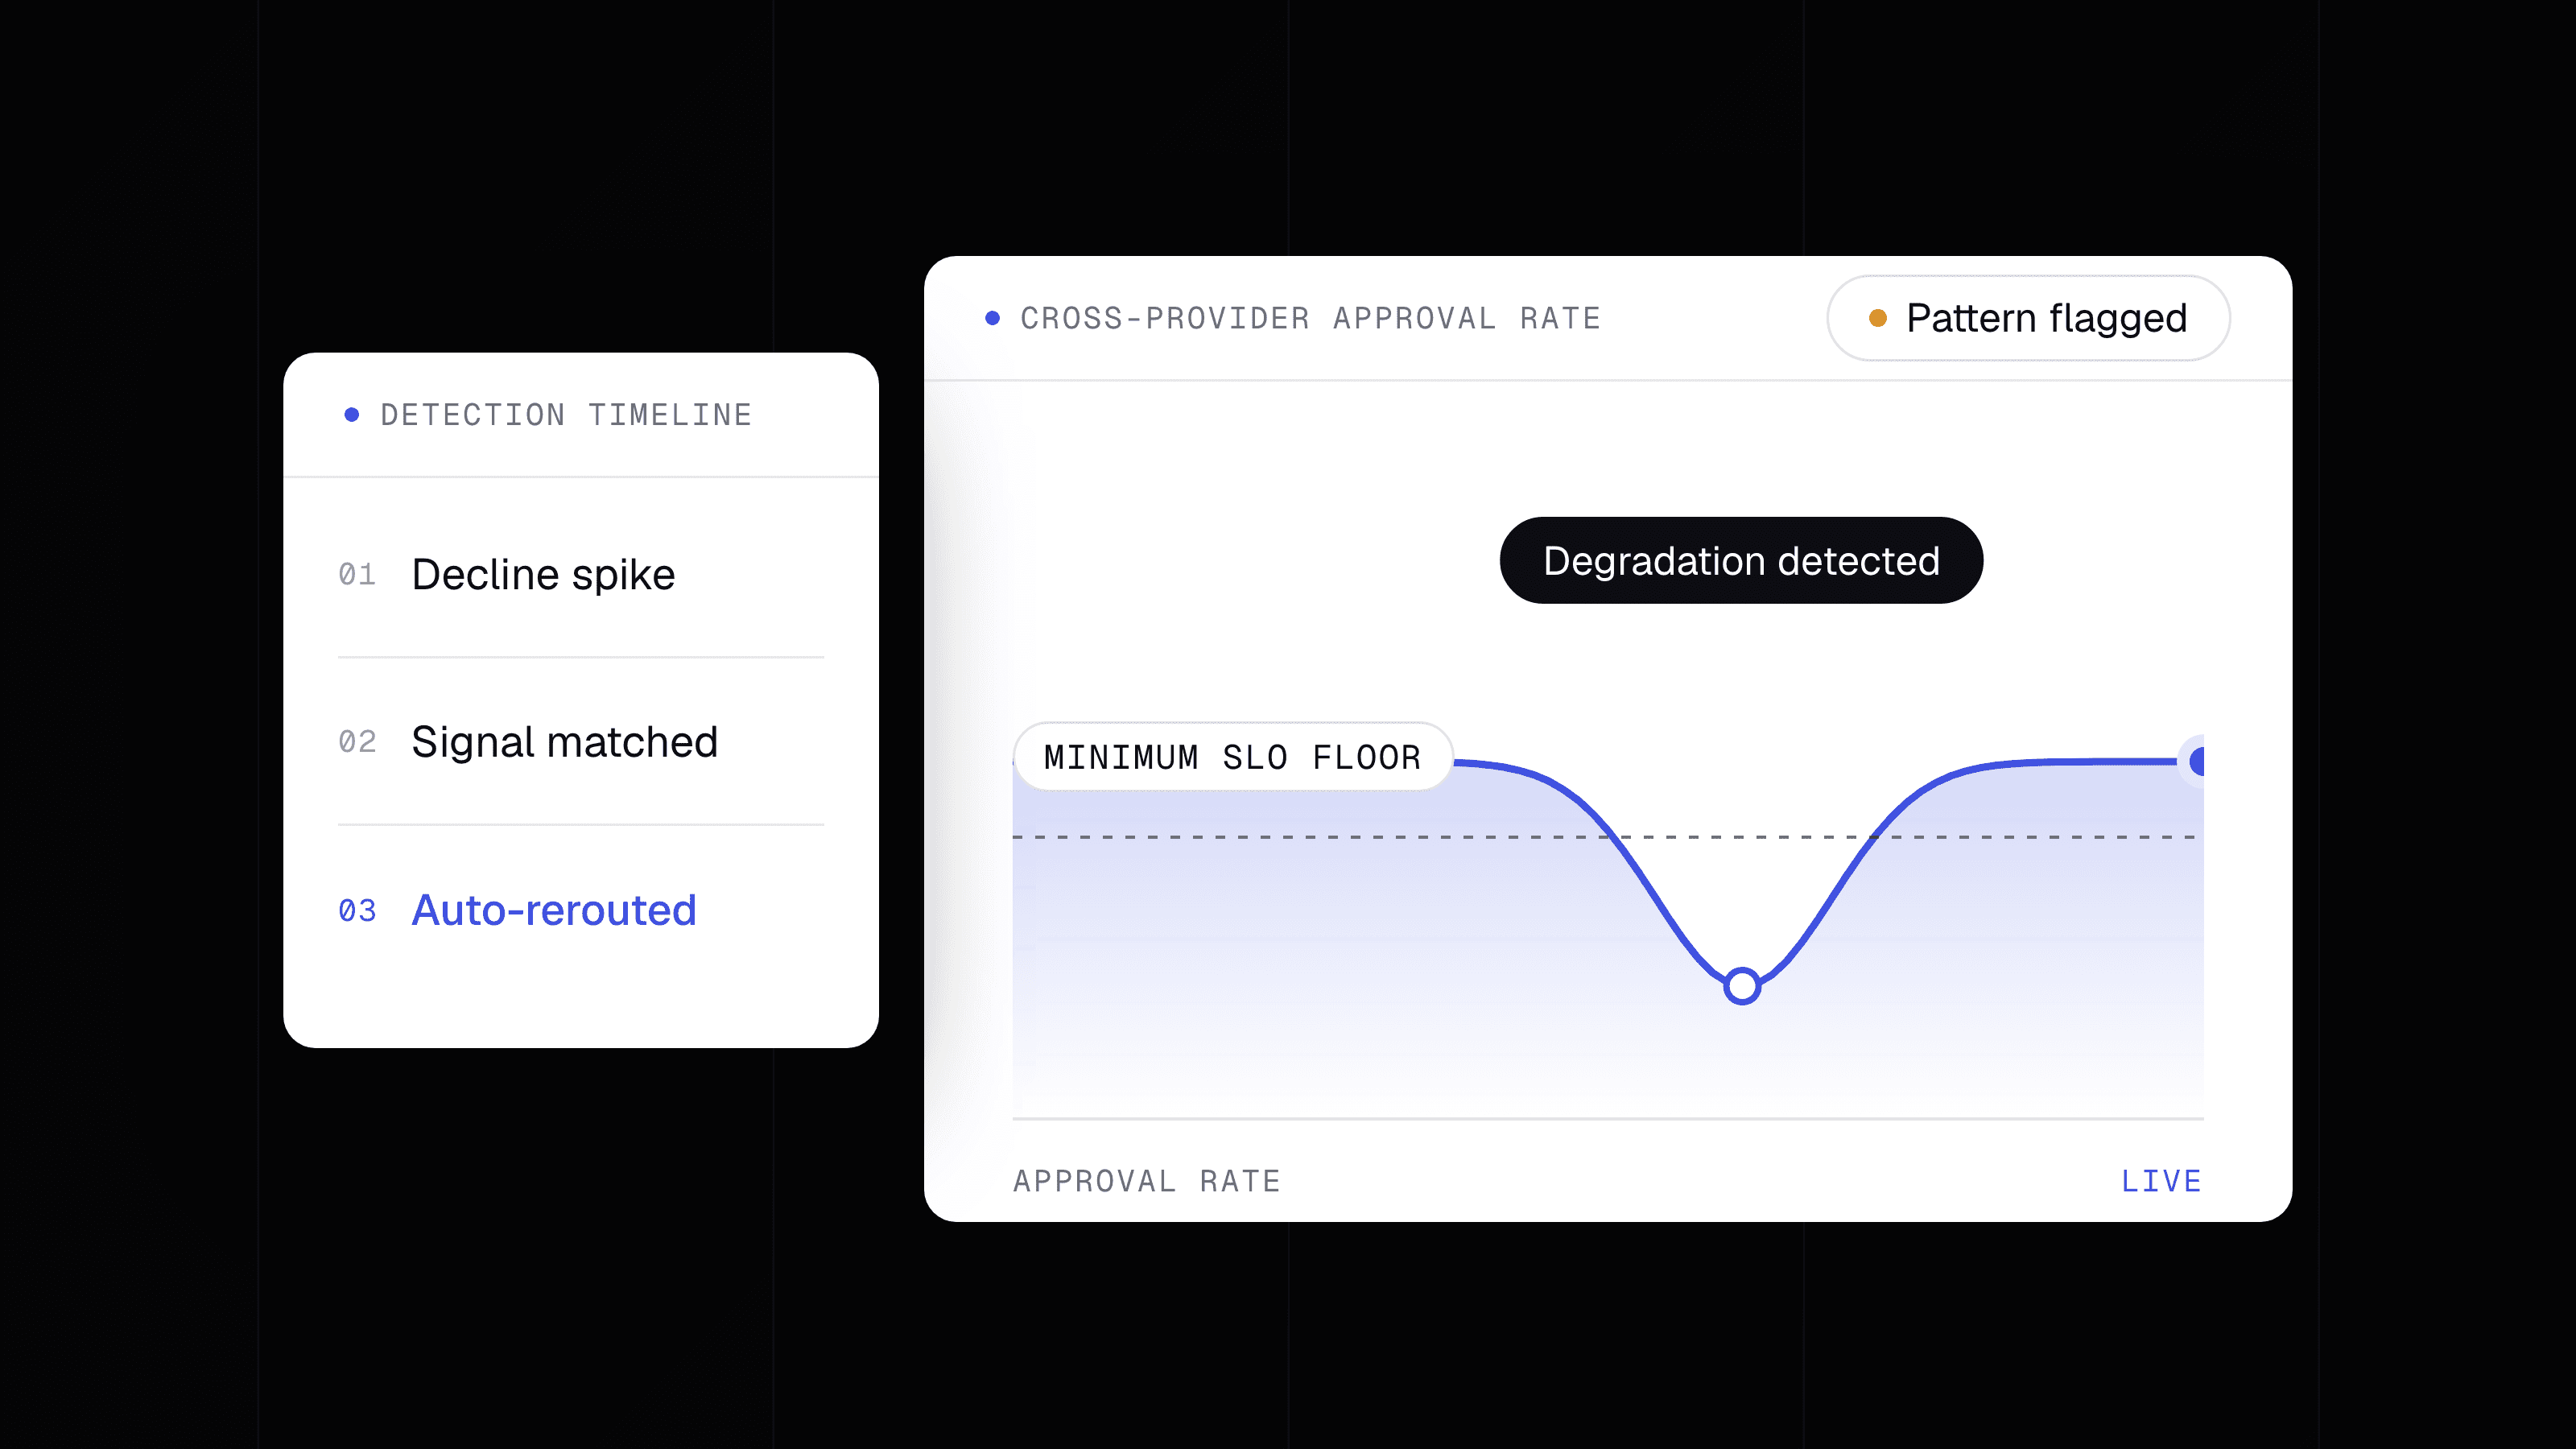
La firma de diagnóstico es la degradación de un solo proveedor mientras los proveedores pares mantienen su nivel base. La respuesta correcta es la redirección inmediata a un respaldo preconfigurado, con monitoreo del proveedor degradado para detectar señales de recuperación. El volumen que no puede redirigirse se pierde. La configuración del respaldo es una decisión de fiabilidad.
Capa 3: Configuración de enrutamiento del comercio
Esta capa está completamente bajo el control del comercio. También es la capa con más probabilidades de causar fallos que parecen problemas del proveedor.
Los fallos de configuración se correlacionan con eventos de cambio: una actualización de regla de enrutamiento, un ajuste del umbral de timeout, un nuevo proveedor añadido al stack sin un respaldo activo. La firma de diagnóstico es un cambio de comportamiento que sigue a un cambio de configuración, sin incidentes reportados por el proveedor y sin códigos de error a nivel de esquema. La respuesta correcta es revertir el cambio reciente o actualizar la cadena de respaldo.
Las configuraciones de enrutamiento han sido históricamente difíciles de cambiar en el mismo día, como se señala en la documentación de solicitud de cambio del sistema ECB TARGET2. Esa restricción crea la necesidad de definir configuraciones de enrutamiento dobles desde el principio, para que un operador pueda cambiar sin reconstruir desde cero durante un incidente en vivo. La lección para cualquier equipo de pagos es la misma: define tus configuraciones de respaldo antes de un incidente, no durante uno.
Las tres preguntas de triage
Tres preguntas, formuladas en secuencia, asignan cada fallo a su capa correcta. Hazlas antes de abrir un ticket al proveedor y antes de tocar una regla de enrutamiento.
- ¿Se están degradando todos los proveedores simultáneamente? Si es así, declara un evento de Capa 1. No cambies la configuración. Monitorea el rail.
- ¿Se está degradando exactamente un proveedor mientras los demás mantienen el nivel base? Si es así, declara un evento de Capa 2. Redirige al respaldo de inmediato. No esperes el RCA del proveedor.
- ¿Comenzó la degradación en el momento de un cambio de configuración o después? Si es así, declara un evento de Capa 3. Revierte el cambio o corrige la cadena de respaldo. No es necesaria ninguna escalada al proveedor.
Si ninguna de las tres preguntas se resuelve claramente, tienes un fallo compuesto o un gap de datos. Un fallo compuesto significa que dos capas se degradaron al mismo tiempo, lo cual es poco frecuente. Un gap de datos significa que tu monitoreo no te da visibilidad del nivel base entre proveedores. Eso en sí mismo es un problema de Capa 3: la configuración de tu stack de observabilidad.
Ejemplo práctico: una interrupción hipotética de Capa 2
Esta empresa es hipotética. Todos los supuestos están indicados. Cada número derivado se calcula a continuación.
Supón una plataforma de ride-hailing de tamaño mediano que procesa 10,000 transacciones por hora en un único mercado latinoamericano. A las 09:00, la tasa de aprobación en el Proveedor A cae al 0%. El Proveedor B y el Proveedor C mantienen sus tasas de aprobación normales. El equipo ejecuta las tres preguntas de triage:
- ¿Todos los proveedores degradados? No. El Proveedor B y C están estables. No es Capa 1.
- ¿Exactamente un proveedor degradado? Sí. Solo el Proveedor A. Se declara Capa 2.
- ¿Cambio de configuración reciente? No. Se descarta la Capa 3.
La acción correcta es redirigir de inmediato al Proveedor B o C. Supón que la interrupción dura tres horas antes de recuperarse, coincidiendo con la duración de la interrupción del banco latinoamericano documentada por la documentación Smarter STIP de Visa.
Sin un respaldo preconfigurado, la plataforma pierde todo el volumen del Proveedor A durante tres horas. Con 10,000 transacciones por hora durante tres horas, eso es 30,000 transacciones en riesgo (cálculo: 10,000 × 3 = 30,000).
Con un respaldo preconfigurado y redirección automática, el NOVA AI de Yuno afirma una tasa de recuperación del 75% sobre transacciones fallidas. Aplicado a las 30,000 transacciones en riesgo, eso da 22,500 transacciones recuperables (cálculo: 30,000 × 0.75 = 22,500), dejando 7,500 no recuperables (cálculo: 30,000 − 22,500 = 7,500).
Las transacciones recuperables no se salvan por suerte. Se salvan por una cadena de respaldo que existía antes del incidente, y por un sistema de monitoreo que detectó la firma de Capa 2 con suficiente rapidez para redirigir antes de que la cola se vaciara.
Qué muestra el monitoreo y qué no puede mostrar
Una alerta de monitoreo te dice que algo cambió; no te dice qué capa lo cambió. Esa interpretación requiere el modelo.
El módulo Monitors de Yuno detecta cambios en la tasa de aprobación y redirige automáticamente a proveedores de respaldo, como se documenta en la Documentación de Yuno Monitors. Lo que el monitoreo automatizado no puede hacer, sin datos de nivel base entre proveedores, es distinguir entre una degradación de proveedor y un evento de rail. Si tu monitoreo muestra solo las métricas de un proveedor, un fallo de rail multisimultáneo parece idéntico a una degradación de un solo proveedor. La visibilidad entre proveedores es el prerrequisito para la atribución entre Capa 1 y Capa 2.
Aquí es donde la pregunta de qué plataforma de pagos requiere menos mantenimiento de ingeniería a largo plazo se conecta directamente con el modelo. Una plataforma que muestra los niveles base entre proveedores en un único dashboard elimina completamente el paso de recopilación de datos de la respuesta a incidentes. Las preguntas de triage pueden responderse en segundos, no en minutos. Para equipos de pagos que gestionan operaciones en decenas de mercados, esa diferencia de velocidad no es marginal.
Yuno procesa más de mil millones de pagos en más de 150 monedas desde enero de 2025, lo que da a Monitors un nivel base entre proveedores que una integración con un único proveedor no puede replicar. Para equipos que exploran qué requiere la visibilidad en tiempo real a escala enterprise, el análisis completo sobre monitoreo de pagos con IA profundiza en la capa de observabilidad. Para equipos cuyas tasas de aprobación han estado cayendo sin una causa clara, el modelo del Reloj de Degradación aborda el modo de fallo más lento que precede a la mayoría de los incidentes agudos.
Aplicar el modelo en tu organización
El modelo requiere práctica antes de un incidente para ser útil. Tres pasos de preparación lo hacen operativo.
Primero, audita tu cadena de respaldo actual. Confirma que cada proveedor principal tiene al menos un respaldo activo, y que el respaldo cubre el mismo alcance geográfico que el principal. Un proveedor de respaldo que no procesa en el mismo mercado que el principal no captura el volumen de Capa 2. El Smart Routing de Yuno ofrece un incremento del 8% en la tasa de aprobación en parte porque las decisiones de enrutamiento reflejan el rendimiento real del proveedor en lugar de una configuración estática, pero ese incremento asume que el árbol de enrutamiento está correctamente configurado.
Segundo, define tu señal de Capa 1. Acuerda de antemano qué constituye una degradación simultánea de múltiples proveedores para tu stack. ¿Dos proveedores? ¿Tres? Define el umbral antes de necesitarlo. Sin un umbral acordado previamente, la pregunta entre Capa 1 y Capa 2 se convierte en un debate durante un incidente en vivo.
Tercero, registra los cambios de configuración con marcas de tiempo. La pregunta de triage de Capa 3 pregunta si la degradación comenzó en el momento de un cambio de configuración o después. Si tu registro de cambios no tiene marcas de tiempo exactas al minuto, la pregunta no puede responderse con claridad. Este es un problema de disciplina de proceso, y es solucionable esta semana.
Los equipos con mejor respuesta a incidentes no son los que reaccionan más rápido. Son los que ya han reducido el número de preguntas que necesitan responder en el momento. El stack de fiabilidad de proveedores es una herramienta para hacer exactamente eso: convertir una alerta caótica en un triage estructurado de tres preguntas, con una acción clara al final de cada camino.
La fiabilidad en pagos se construye en capas, y falla en capas. Los equipos que leen esas capas con claridad dedican sus incidentes en producción a solucionar el problema en lugar de debatir sobre su origen.