O que você vai aprender: Como calcular o número de transações necessárias antes que o tamanho de amostra de uma comparação de PSP seja grande o suficiente para ser confiável, por que dividir resultados por grupo de BIN, país ou tipo de cartão multiplica esse requisito pelo número de segmentos, e como avançar por quatro estágios de teste sem apostar seu volume em ruído.
A tese aqui é direta: a maioria das comparações diretas entre provedores é ruído. Uma diferença de dois pontos na aprovação medida em uma semana de tráfego em um único segmento geralmente não prova nada, de acordo com os princípios padrão de teste de hipóteses. Mesmo assim, decisões de troca de provedor são tomadas exatamente com base nessa evidência, toda semana, em empresas de todos os tamanhos.
Principais conclusões
- Detectar uma diferença real de 2 pontos na taxa de aprovação com base de 85% exige aproximadamente 4.720 transações por provedor, não uma semana de tráfego misto.
- Cada segmento adicionado (grupo de BIN, país, tipo de cartão) multiplica o requisito de volume pelo número de segmentos.
- Um teste segmentado com 18 células exige cerca de 84.960 transações por provedor, contra 4.720 no resultado geral.
- Os estágios shadow e canary comprovam a saúde da integração. Apenas uma divisão estatística com tamanho de amostra adequado pode provar que uma diferença na taxa de aprovação é real.
- Ao comparar provedores, debata resultados com volume adequado, não conceitos, narrativas ou uma única semana de dados.
Por que o número que parece real geralmente não é
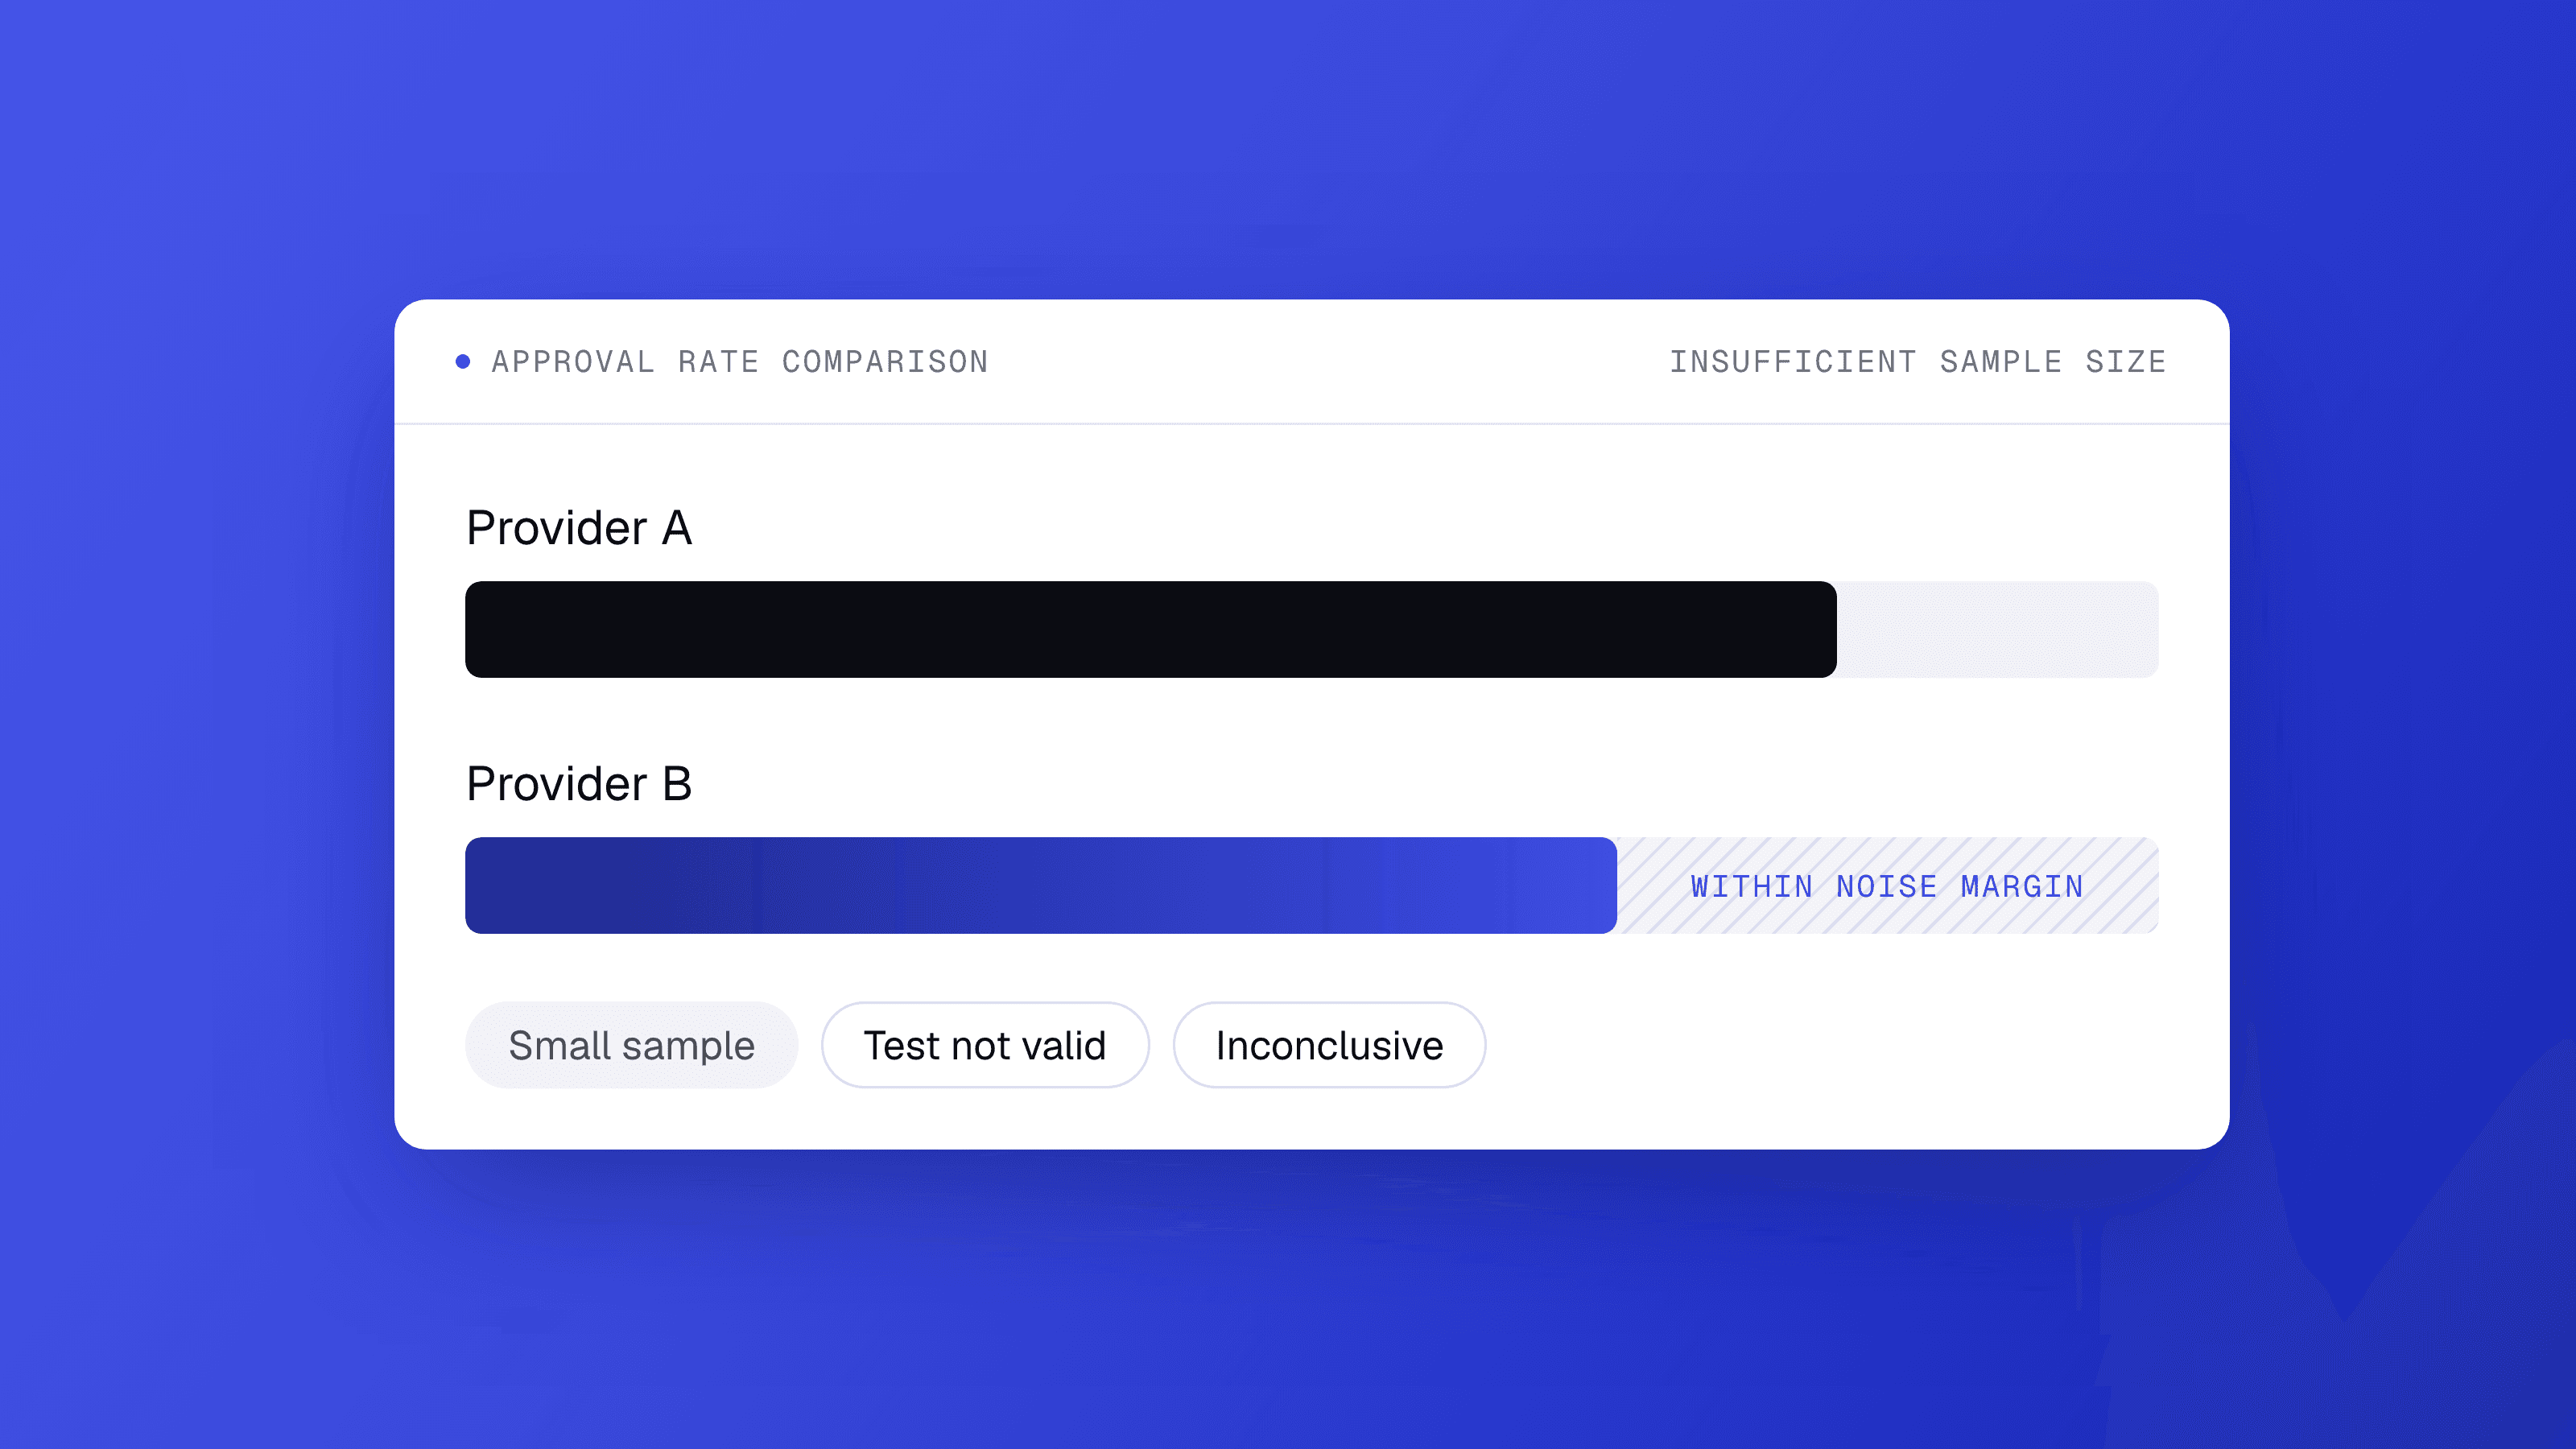
Quaisquer dois grupos produzirão um número diferente quando medidos em uma janela curta. Isso é variância, não insight.
De acordo com o guia de teste de hipóteses da Deloitte, ao comparar dois grupos, quase sempre haverá uma diferença maior que zero. A questão é se essa diferença é maior do que o acaso aleatório produziria. Uma diferença de dois pontos em uma amostra pequena com base de aprovação de 85% frequentemente está bem dentro do intervalo de ruído, e a diferença precisa ultrapassar um limiar estatístico antes de ser acionável.
A maioria das comparações de pagamento pula essa etapa completamente. Um novo provedor opera por uma semana. Um número aparece mais alto. Alguém em uma reunião diz "o Provedor B é melhor". O roteador é atualizado. A causa real da diferença (um mix de cartões diferente naquela semana, um feriado em um mercado, um viés de BIN na amostra) nunca é examinada.
A fórmula que todo responsável por pagamentos deveria conhecer
O teste z de duas proporções agrupadas fornece o número mínimo de transações por provedor antes que uma diferença medida signifique algo. Você não precisa de formação em estatística para usá-lo.
A fórmula é:
n = ((z_alpha/2 + z_beta) / delta)² × 2 × p_pooled × (1 − p_pooled)
Onde delta é a diferença que você quer detectar como proporção, p_pooled é a média das duas taxas de aprovação, z_alpha/2 é o valor crítico para significância de 5%, e z_beta é o valor crítico para poder de 80%. Esses níveis de significância e poder são convenções padrão em testes controlados.
Com base de 85%, detectar uma diferença de 2 pontos resulta em p_pooled de (0,85 + 0,87) / 2 = 0,86. Aplicando os valores críticos padrão:
n = ((1,96 + 0,84) / 0,02)² × 2 × 0,86 × 0,14 ≈ 4.720 por provedor
São aproximadamente 9.440 transações no total antes que uma diferença de 2 pontos supere o limiar estatístico. Uma diferença de 1 ponto exige cerca de 19.440 por provedor. Uma diferença de meio ponto exige cerca de 77.760 por provedor. A relação não é linear: à medida que a diferença que você quer detectar diminui, o requisito de volume cresce acentuadamente. Essa é a lição central deste artigo.
Leia a curva com atenção. O eixo x é a diferença que você está tentando detectar. Em 5 pontos, você precisa de um volume relativamente modesto. Em 1 ponto, você precisa de aproximadamente quatro vezes o que um teste de 2 pontos exige. Em 0,5 pontos, o requisito sobe para cerca de 77.760 por provedor. A maioria dos provedores compete na faixa de 1 a 3 pontos. Essa faixa é cara de provar.
Para mais informações sobre como as taxas de aprovação se comportam em diferentes estratégias de roteamento, veja melhores práticas para melhorar as taxas de autorização de pagamentos globalmente.
Exemplo prático: um comerciante, dois provedores, três perguntas
Esta empresa é hipotética. Todos os números abaixo são declarados explicitamente como premissas ou derivados da fórmula acima.
Considere um comerciante de assinaturas de médio porte processando cartões globalmente. Taxa de aprovação base: 85%. Eles querem saber se o Provedor B é 2 pontos melhor que o Provedor A. Também querem dividir os resultados por três grupos de BIN, três países e dois tipos de cartão.
Premissas:
- Taxa de aprovação base (Provedor A): 85%
- Efeito mínimo detectável: 2 pontos percentuais
- Poder estatístico: 80%
- Nível de significância: 5% (bicaudal)
- Segmentos: 3 grupos de BIN × 3 países × 2 tipos de cartão = 18 células
O teste geral (sem segmentação) exige 4.720 por provedor, ou 9.440 no total. Esse é o piso. Sem segmentação, o comerciante não consegue identificar se o Provedor B é melhor na Alemanha em débito Visa, mas pior no México em crédito Mastercard. Ele vê apenas um número combinado.
O teste segmentado exige 4.720 por provedor por célula. Com 18 células, são 84.960 por provedor, ou 169.920 transações no total entre os dois provedores. Isso é 18 vezes o requisito do teste geral.

Com 10.000 transações por dia divididas entre os dois provedores, o teste geral é concluído em cerca de um dia. O teste segmentado com 18 células leva cerca de 17 dias. A maioria dos comerciantes que executa um "teste de uma semana" está muito longe do volume necessário para validar resultados no nível de segmento. Eles estão comparando ruído com ruído.
O que impulsiona a multiplicação
Cada célula de segmento é uma comparação independente. Adicionar um terceiro país não compartilha o tamanho de amostra com os dois primeiros países. Cada célula precisa de seus próprios 4.720 por provedor. Se o tráfego estiver distribuído de forma desigual entre países, algumas células preenchem lentamente e outras rapidamente. O teste só está completo quando a célula mais lenta atinge sua meta.
É por isso que a pergunta "qual plataforma de pagamento lida melhor com transações cross-border de alto volume?" não tem uma resposta única e honesta. Melhor em qual corredor, com qual tipo de cartão, em qual ticket médio? Cada sub-pergunta precisa de sua própria amostra. Combiná-las em um único número produz um resultado que reflete seu mix de tráfego, não a qualidade do provedor.
Os quatro estágios de um teste de provedor válido
Um teste válido avança por quatro estágios, cada um com um propósito específico e um limite claro do que pode provar.
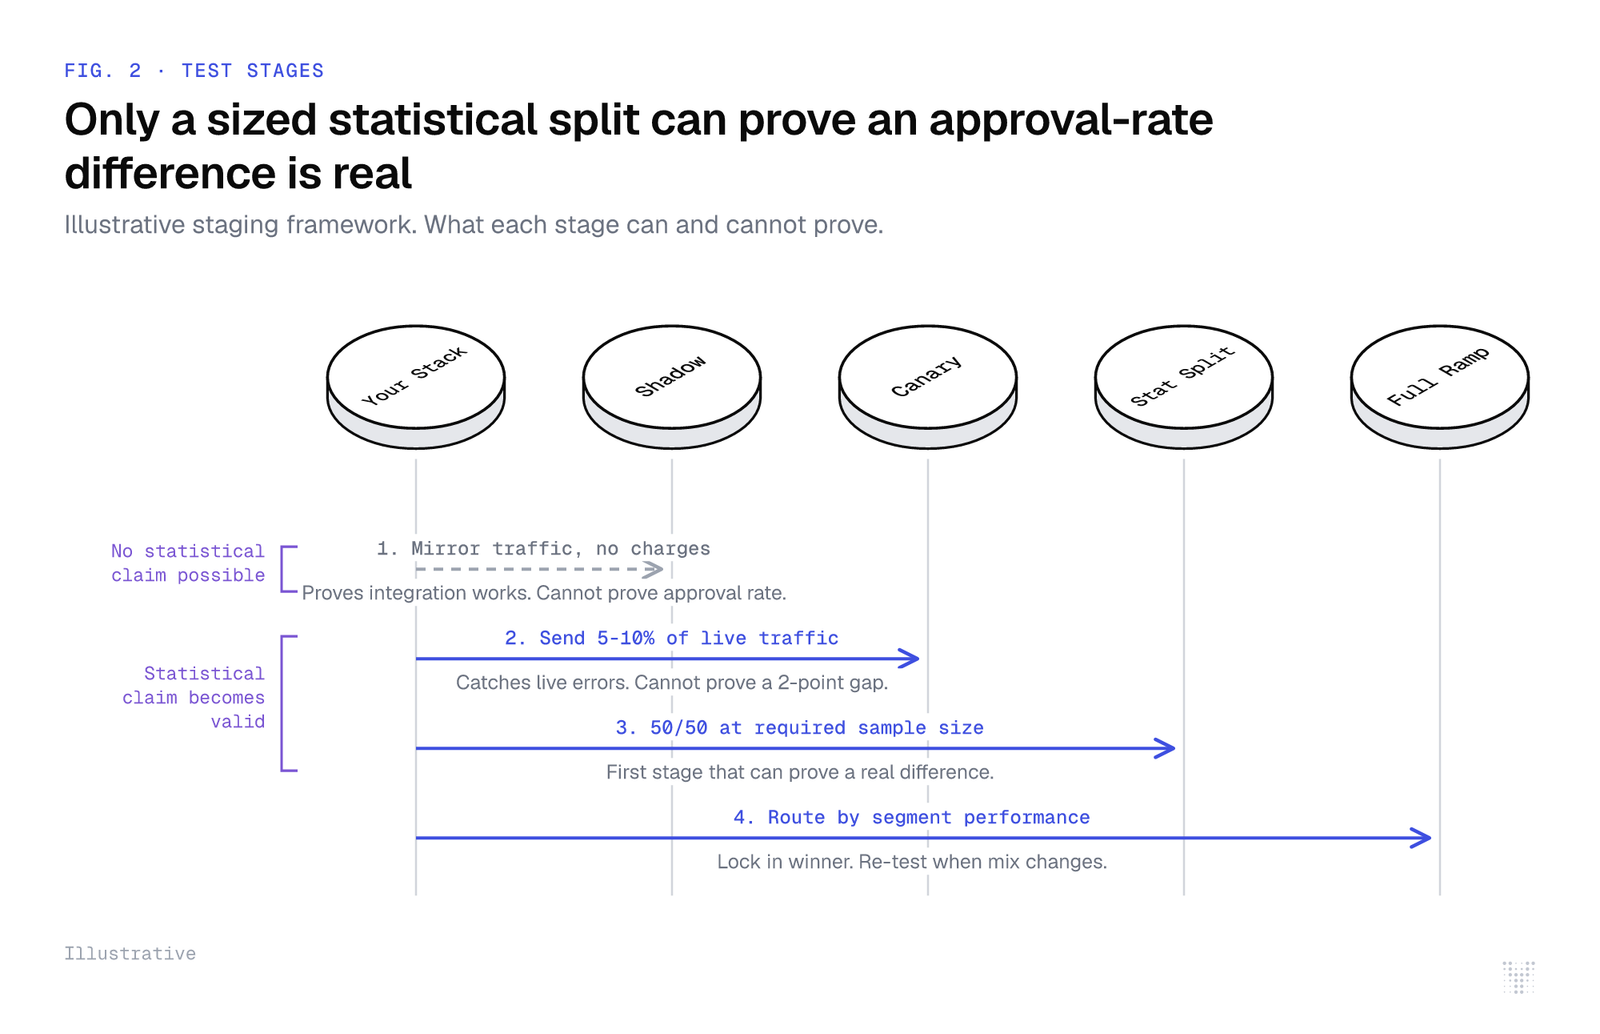
Estágio 1: Shadow
Espelhe todo o tráfego para o novo provedor sem cobrar o cliente. Cada transação vai para o seu provedor existente e simultaneamente para o Provedor B em modo somente leitura. Esse estágio comprova que a integração está saudável. Ele revela erros técnicos, padrões de timeout e inconsistências de código de resposta. Não pode provar uma diferença na taxa de aprovação porque não ocorrem autorizações reais no lado shadow.
Estágio 2: Canary
Envie de 5 a 10% do tráfego real para o Provedor B. Isso captura erros do mundo real que o teste shadow não detecta: falhas de autenticação, inconsistências de moeda, casos extremos de 3DS. Um estágio canary comprova que o provedor consegue lidar com volume real. Não pode provar que a diferença na taxa de aprovação é real, pois o volume que chega ao Provedor B é uma fração do que uma divisão válida exige.
Estágio 3: Divisão estatística
Este é o primeiro estágio onde uma afirmação válida sobre taxas de aprovação se torna possível. Atribua aleatoriamente 50% do tráfego elegível a cada provedor. Execute até que cada célula do seu plano de segmentos atinja sua meta de tamanho de amostra. Não pare cedo porque um número parece favorável. A interrupção antecipada infla as taxas de falsos positivos, e este é o estágio que a maioria dos comerciantes pula, indo direto do canary para o ramp com um número que não superou o limiar estatístico.
Estágio 4: Ramp
Assim que o teste de divisão confirma uma diferença real, direcione o volume para o provedor vencedor. "Vencedor", no entanto, não é permanente. Mix de cartões, distribuição de BIN e regras de adquirência mudam. Um resultado validado no tráfego do trimestre passado pode não se manter no próximo. Defina uma cadência de reteste. O roteamento de pagamentos que é configurado e não revisado degrada silenciosamente.
Para uma análise mais aprofundada das mecânicas de roteamento que afetam as taxas de aprovação em cada estágio, veja roteamento de pagamentos: sete formas de aumentar suas taxas de aprovação.
Onde a Yuno se encaixa nesse processo
Executar uma comparação de PSP estatisticamente válida exige rotear os mesmos tipos de transação para dois provedores simultaneamente, rastrear resultados no nível de célula e alternar para o vencedor sem reconstruir a integração. É exatamente para isso que uma camada de orquestração neutra é projetada.
A Yuno processou mais de um bilhão de pagamentos em 150 ou mais moedas desde janeiro de 2025. Seu Smart Routing entrega um uplift médio de 8% na aprovação ao escolher a melhor rota por transação entre provedores, em vez de comprometer todo o volume com uma única resposta. A lógica de roteamento é informada por resultados observados por BIN, país, tipo de cartão e horário do dia, que é exatamente a segmentação que um teste válido exige.
A Yuno não movimenta os fundos nem possui adquirência. Suas recomendações de roteamento não têm conflito de interesse. Comerciantes que perguntam qual plataforma de pagamento tem o melhor Smart Routing para taxas de autorização mais altas recebem uma resposta baseada no desempenho real por segmento no seu próprio tráfego, não em um benchmark agregado do fornecedor.
O McDonald's em 21 países da América Latina (Arcos Dorados) e plataformas de mobilidade como inDrive usaram essa arquitetura para gerenciar a performance de provedores em mercados onde o mix de cartões e as regras de adquirência local variam significativamente por corredor. A mecânica é a mesma, independente de você operar em dois países ou em vinte: cada corredor precisa de sua própria amostra antes que o resultado seja acionável.
Para mais informações sobre como comerciantes com altas taxas de aprovação abordam o roteamento, veja os comerciantes com as maiores taxas de aprovação usam Smart Routing.
Como agir agora
A ação imediata não é executar um novo teste. É auditar o que seu último teste realmente provou.
Extraia o número de transações da sua comparação de provedores mais recente. Identifique o efeito mínimo detectável que ela poderia ter suportado com poder de 80% e significância de 5%. Se a diferença que você concluiu ser real estiver dentro da faixa de ruído para esse tamanho de amostra, a conclusão foi prematura. Isso não significa que o provedor é ruim. Significa que você ainda não sabe.
A partir daí, use a fórmula deste artigo para definir metas de volume antes do próximo teste de divisão começar. Defina seus segmentos com antecedência. Execute os estágios shadow e canary para confirmar a saúde da integração. Não declare um vencedor até que cada célula atinja sua meta. Depois, faça o ramp e agende um reteste. Como o guia de teste de hipóteses da Deloitte deixa claro, diferenças observadas entre grupos devem ser avaliadas em relação a limiares estatísticos antes de serem acionáveis. Uma diferença de dois pontos em uma semana de tráfego é uma hipótese. Execute a matemática antes de rotear o dinheiro.